Rápido e Devagar: o que Kahneman tem a ver com o futuro da IA, e por que o Jev não quer conversar com você
Por Digital Solutions do Brasil
1. Os dois sistemas de Daniel Kahneman
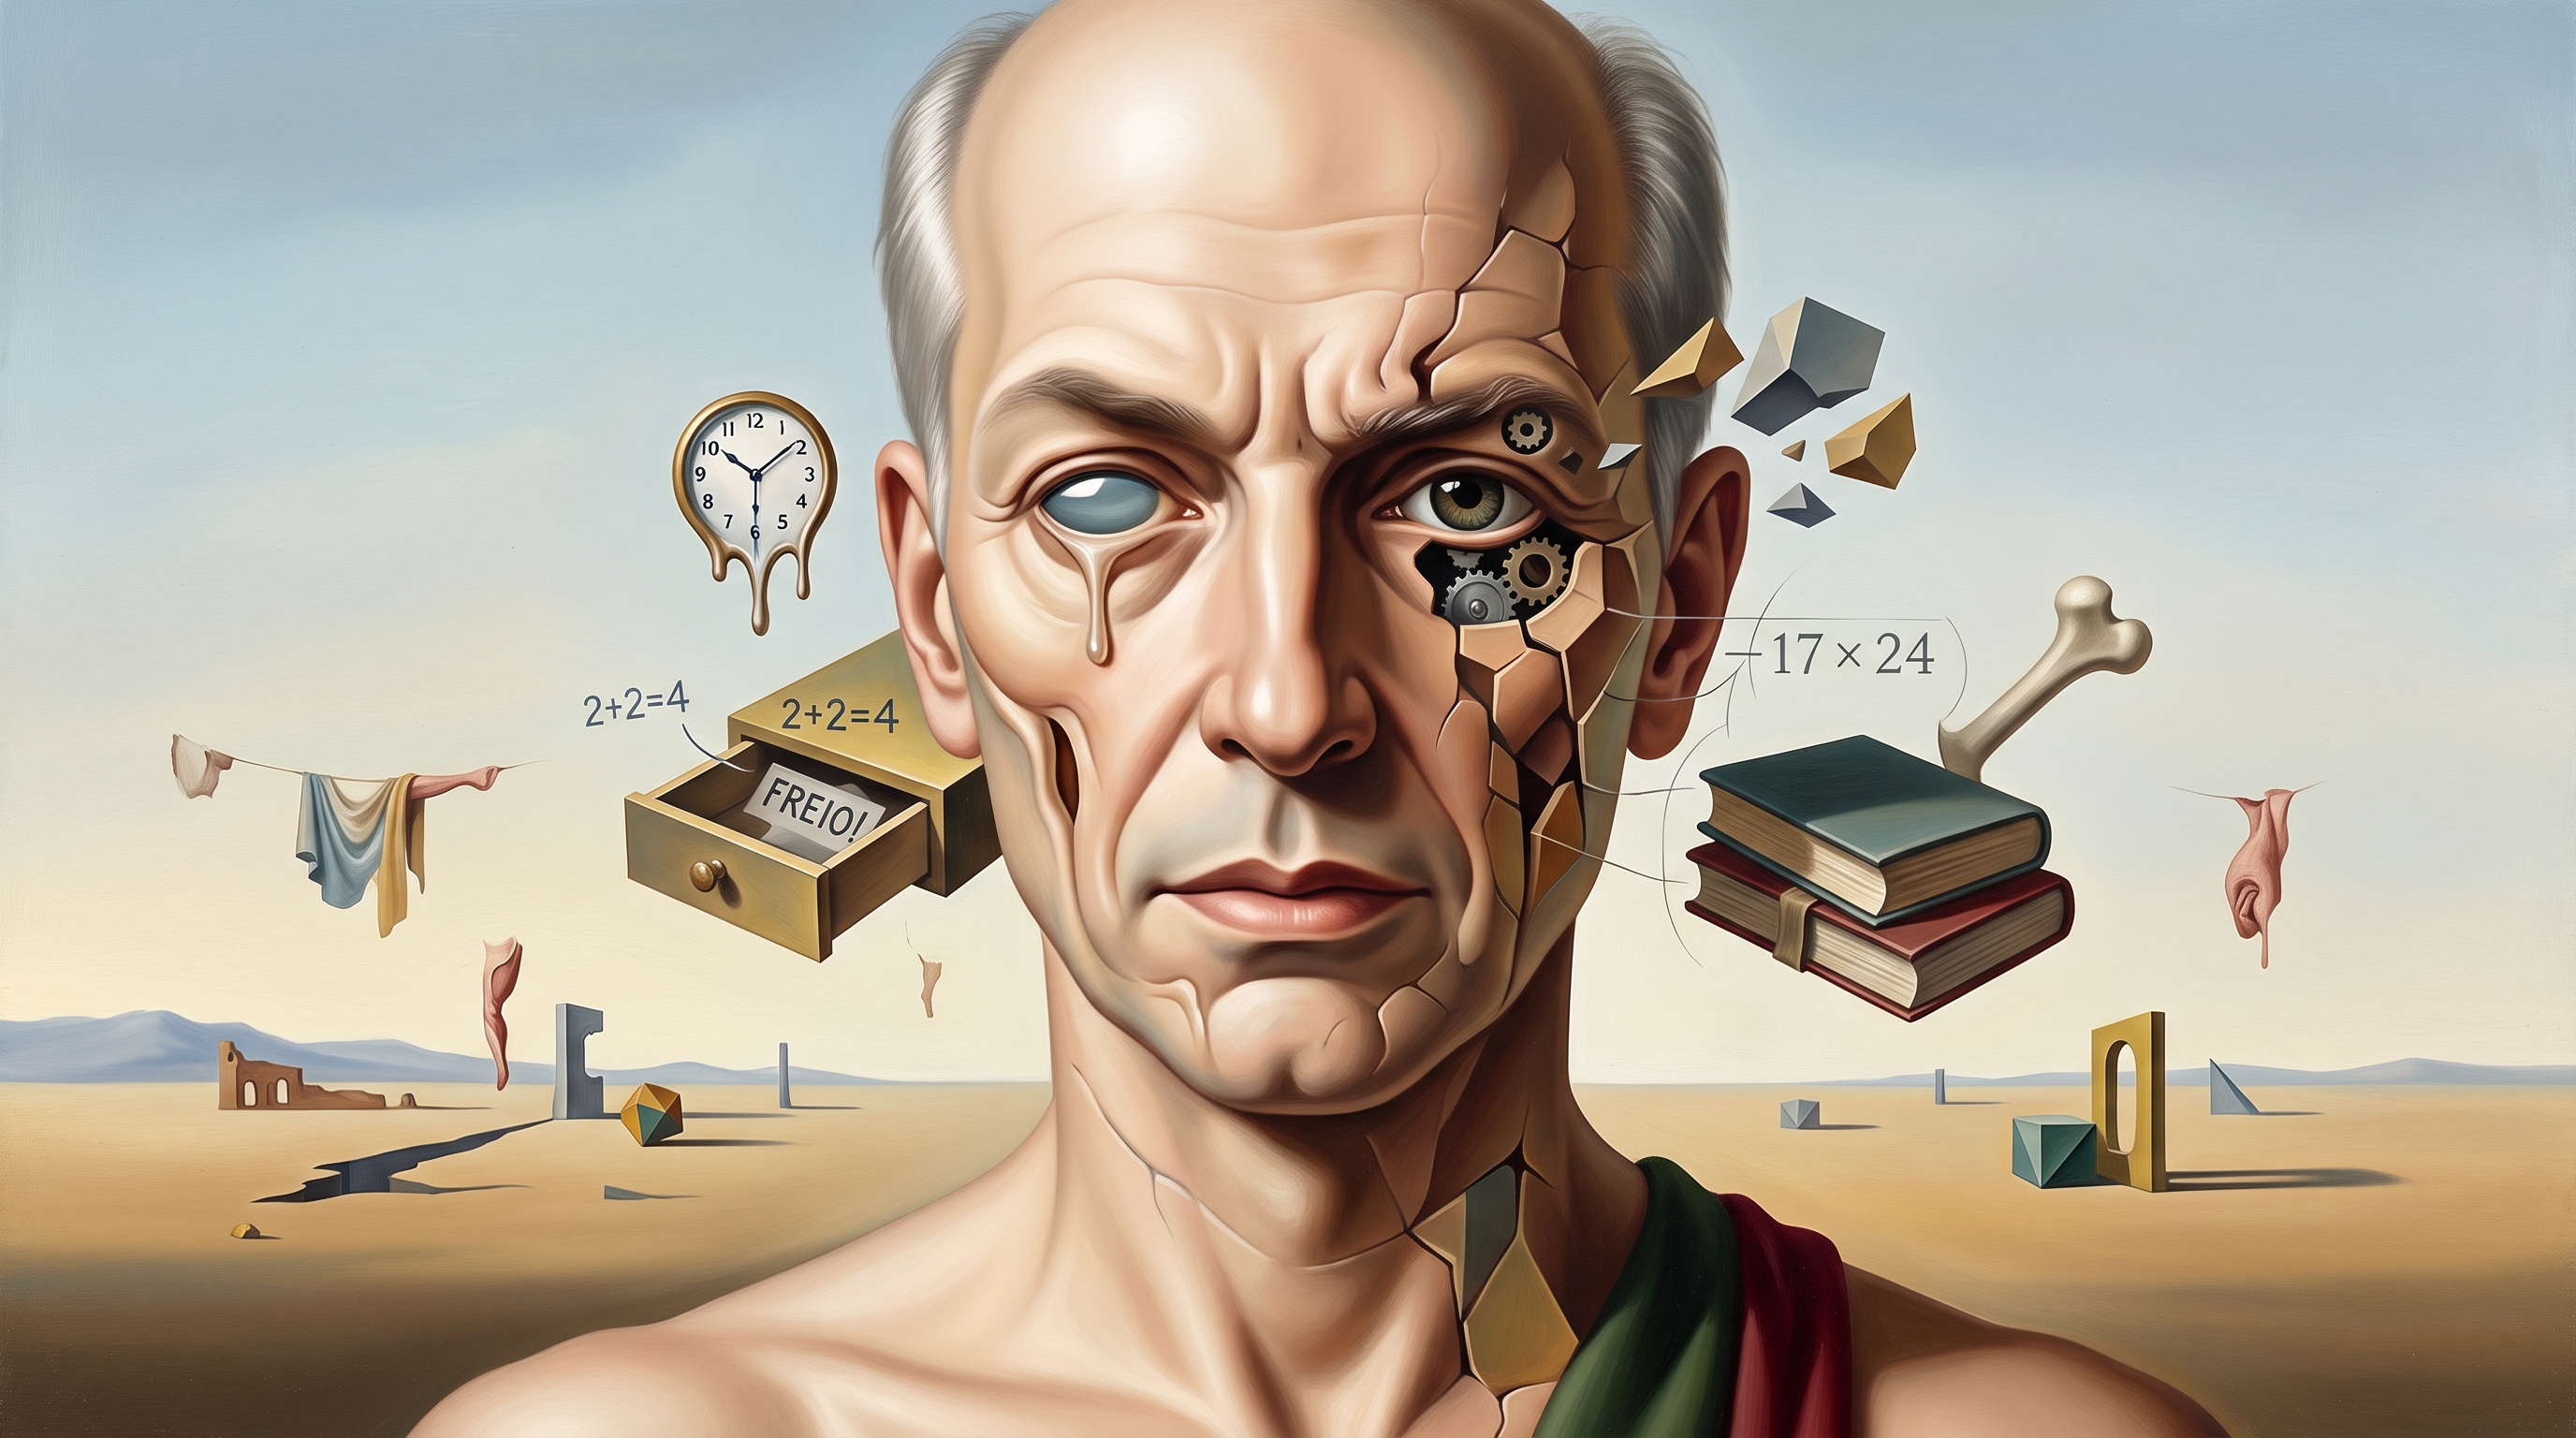
Em 2002, Daniel Kahneman (psicólogo, não economista) recebeu o Prêmio Nobel de Ciências Econômicas por mostrar que os seres humanos não tomam decisões como os modelos racionais da economia supunham. Uma década depois, ele consolidou essa pesquisa no livro Rápido e Devagar: Duas Formas de Pensar (Thinking, Fast and Slow, 2011), que se tornou uma das obras mais influentes da ciência cognitiva moderna.
A ideia central é elegante na sua simplicidade: a mente humana opera com dois modos de pensamento, que Kahneman chamou de Sistema 1 e Sistema 2.
Sistema 1 · rápido
Automático, intuitivo e quase sem custo consciente. É ele que responde “2 + 2” antes de você terminar de ler a pergunta, que reconhece raiva numa foto de um rosto, que freia o carro quando algo cruza a pista. Opera o tempo todo, sem esforço, e responde pela imensa maioria das decisões do dia, quase todas tão pequenas que nem percebemos que foram decisões.
Sistema 2 · devagar
Deliberado, analítico e custoso. É ele que calcula 17 × 24, que revisa um contrato cláusula por cláusula, que compara argumentos antes de formar uma opinião. Consome energia mental de verdade, exige atenção, e por isso o cérebro o economiza: a tendência natural é deixar o Sistema 1 resolver, e só chamar o Sistema 2 quando a situação exige.
“A característica definidora do Sistema 2 é que suas operações exigem esforço, e uma de suas principais características é a preguiça: a relutância em investir mais esforço do que o estritamente necessário.”
Daniel Kahneman, Rápido e Devagar (2011)
Essa divisão de trabalho não é um defeito. É uma otimização evolutiva brilhante. Um cérebro que deliberasse sobre cada estímulo travaria antes do meio-dia. A inteligência humana é, em grande parte, a arte de alocar o tipo certo de processamento para o tipo certo de problema: reflexo barato para o recorrente, deliberação cara para o que é novo e importante.
Guarde essa frase. Ela é a chave de tudo que vem a seguir.
2. A IA mimetiza a cognição humana e herda o mesmo problema de alocação
Não por acaso, os grandes modelos de linguagem se parecem muito com o Sistema 2 de Kahneman. Um LLM é deliberado por construção: é autoregressivo, gera um token depois do outro, cada um condicionado a todos os anteriores. Raciocina em voz alta, escreve, explica, argumenta. Essa é exatamente a fonte do seu poder: a saída aberta permite conversa, código, relatório, tradução, poesia.
Mas essa mesma arquitetura tem um custo embutido, e a indústria inteira vem pagando essa conta sem perceber. Repare no que acontece dentro de praticamente todo software que “usa IA” hoje: o sistema monta um prompt, pede ao modelo que escreva alguma coisa, e depois escreve código para interpretar o que o modelo escreveu. Pede JSON, torce para vir JSON, valida o esquema, trata o caso em que veio um textinho explicativo antes da chave, tenta de novo quando falha.
O problema é que a maioria dessas chamadas não precisa de linguagem nenhuma. Precisa de uma decisão: A, B ou C? Para qual fila vai este ticket? Este documento é um contrato ou uma petição? Esta transação é suspeita? Esta resposta do agente está dentro da política?
Quando usamos um modelo deliberado e complexo para cada uma dessas microdecisões, pagamos três preços ao mesmo tempo:
Acurácia
Cada decisão espremida num formato de texto passa por uma camada de geração e outra de parsing, e cada camada é uma oportunidade de erro: o formato quebra, a opção vem inventada, a interpretação diverge. Além disso, a saída aberta convida o modelo a “conversar” onde deveria apenas escolher, e a alucinar estrutura onde deveria respeitar um esquema.
Latência
Gerar texto token a token leva segundos, tipicamente de 3 a 30 numa chamada a um modelo de fronteira. Para um agente que toma dezenas de microdecisões por tarefa, isso se acumula em minutos. Para qualquer laço em tempo real, é simplesmente inviável.
Custo
Cada token gerado é cobrado. Multiplique uma decisão de poucos bytes por milhares de chamadas por dia, por dezenas de decisões por tarefa, e a fatura da “IA no produto” vira uma linha relevante do orçamento.
Em termos kahnemanianos: estamos usando o Sistema 2, caro, lento e deliberado, para fazer o trabalho do Sistema 1. É como se um cérebro deliberasse, cláusula por cláusula, sobre cada “2 + 2” que aparecesse na tela. Funciona, mas é um desperdício estrutural.
Foi exatamente essa observação que deu origem à empresa e ao modelo que vamos examinar agora.
3. TypeSafe AI e o Jev: dois anos em silêncio para construir o “Sistema 1” do software
A TypeSafe AI é um laboratório de San Francisco fundado em 2024 por Diogo Almeida (ex-pesquisador da OpenAI que trabalhou em RLHF, InstructGPT e ChatGPT), ao lado de Erik Gafni (CTO) e Sasha Sheng (COO, ex-Meta e FAIR). A empresa passou dois anos inteiros em stealth mode, sem produto público, sem blog de pesquisa, sem presença: apenas desenvolvendo uma tese e um modelo.
A tese é a pergunta incômoda da seção anterior: e se boa parte das chamadas de IA dentro de um software não precisasse de linguagem nenhuma?
Em 15 de setembro de 2026, a TypeSafe saiu do stealth anunciando uma rodada seed de US$ 40 milhões liderada pela DCVC (com valuation reportado em torno de US$ 200 milhões) e seu primeiro modelo público: o Jev, inaugural de uma categoria que a empresa batizou de System One Models, nome que homenageia explicitamente o Sistema 1 de Kahneman. O nome do modelo, por sua vez, é referência a William Stanley Jevons e ao paradoxo que leva seu nome: quando o custo de um recurso cai por uma ordem de grandeza, o consumo total tende a aumentar, não diminuir. A aposta embutida no nome é que decisões de máquina baratas o suficiente para serem chamadas dez vezes por segundo vão multiplicar, e não economizar, os lugares onde a IA é usada.
A proposta do Jev cabe numa frase, no slogan oficial da empresa:
“Unstructured state in, typed probabilistic decisions out.”
TypeSafe AI, Introducing System One Models and Jev (2026)
Como funciona
O fluxo inverte a lógica do LLM. Em vez de enviar um prompt e receber texto livre, o desenvolvedor envia duas coisas: o estado (a situação concreta: um ticket, um documento, um log, uma mensagem, até 32 mil tokens) e um conjunto de perguntas tipadas, com o espaço de respostas declarado antecipadamente. O Jev responde através de apenas três primitivas de saída:
Choice
Escolhe uma opção dentro de uma lista que você definiu, com a probabilidade de cada alternativa (até 255 opções diretamente; acima disso, um esquema em duas etapas).
Score
Devolve uma posição ponderada por probabilidade numa escala ordenada que você define.
Noul
Devolve a probabilidade de uma condição sim/não ser verdadeira.
Não há prosa no meio do caminho. Uma única chamada pode responder várias perguntas em paralelo: dado um e-mail de suporte, o Jev devolve de uma vez o departamento de destino, a urgência, o risco de reembolso e se um humano deve intervir, cada resposta com sua probabilidade calibrada. É o que a empresa chama de “intelligent if-statement”: um if com compreensão semântica de propósito geral.
O treinamento usa um método proprietário chamado RLCD, Reinforcement Learning for Calibrated Decisions, descrito por Almeida como um descendente do RLHF (a técnica que ele ajudou a criar na OpenAI) adaptado do espaço de texto para o espaço de decisões. O objetivo declarado é a calibração: que uma confiança de 90% corresponda, de fato, a ~90% de acerto, o que permite ao software agir diferente conforme a confiança: alta, executa automático; intermediária, consulta outro modelo; baixa, escala para um humano.
Os números divulgados
Jev · dados do fabricante
| Latência end-to-end | 70 ms a 500 ms por requisição |
| Ganho alegado | 40× a 200× mais rápido que LLMs de fronteira em tarefas de decisão |
| Preço de entrada | US$ 0,042 por milhão de tokens |
| Preço de saída | Gratuito: não há texto gerado para cobrar |
| Comparativo publicado | 0,114 s (Jev) × 8,566 s (modelo generativo de ponta) na mesma tarefa |
As demonstrações de lançamento foram pensadas para provar o laço em tempo real: o Jev jogando DOOM a cerca de 10 decisões por segundo (custo de ~US$ 7/hora de inferência; atenção: o estado chega como texto estruturado, não como pixels da tela) e o Wikiracing, navegando da Wikipédia de uma página a outra só escolhendo links, uma decisão boa por segundo atrás da outra. Em dias, o modelo estava no OpenRouter e ganhou integrações da Vercel, Cloudflare, LangChain e Pydantic AI.
Rigor jornalístico
Os números acima são benchmarks do próprio fabricante e ainda aguardam validação independente ampla. Testes públicos iniciais de terceiros foram encorajadores: um engenheiro da Vercel relatou ganhos de 5× a 18× em velocidade com melhora de acurácia num classificador de segurança; outro teste comparando com o Gemini achou o Jev bem mais barato, com acurácia ligeiramente menor. E vale lembrar o viés apontado pelo The Register: comparar a latência de uma decisão em espaço fechado com a de um texto gerado não é comparar a mesma coisa.
O que “zero hallucinations” realmente significa
A TypeSafe usa linguagem forte de type safety, e é preciso traduzi-la com honestidade: o que está garantido é o formato: o modelo jamais devolve uma estrutura fora dos tipos declarados. O erro de esquema está eliminado por construção. O erro de decisão não: o Jev pode perfeitamente escolher a alternativa errada dentro do espaço permitido. A própria existência da probabilidade e dos limiares de confiança é a admissão disso. Type safety garante a forma da resposta, não a sua verdade.
4. Casos de uso: onde o “Sistema 1” do software entra em cena
O padrão que emerge dos primeiros times que adotaram o modelo é simples: encontre uma fila cara de informação entrando no seu negócio e coloque uma decisão tipada na frente dela. Classificar, rotear, pontuar, extrair, verificar, julgar, aplicar guardrails, abrir branches em workflows: tudo que é entrada complexa e saída curta é candidato.
4.1 Atendimento e operações
O exemplo canônico: um cliente escreve “minha fatura veio duplicada este mês”. Antes de qualquer resposta, o sistema precisa rotear: Financeiro, Vendas, Suporte, Cancelamento. Hoje isso custa uma chamada inteira de LLM; com um modelo de decisão, custa milissegundos e centavos de centavo, com confiança anexada para decidir entre automação e revisão humana.
4.2 RAG agêntico e agentes
Num RAG agêntico com bases vetoriais separadas, a primeira decisão, em qual base buscar?, antecede qualquer recuperação de documento. O desenho fica: pergunta → decisão tipada → base certa → RAG → LLM → resposta. O modelo de decisão decide, o RAG busca, o LLM responde. Dentro de um agente complexo, dezenas de microescolhas por tarefa (qual ferramenta, qual API, se a informação basta, se escala para humano) deixam de custar segundos cada uma.
É a mesma camada que discutimos em roteamento de agentes com Skills, CoT e RAG, agora com um modelo dedicado a executá-la, e o mesmo princípio de arquitetura multi-modelo: o modelo certo para cada tipo de trabalho.
4.3 Jurídico
Poucos setores são tão feitos de decisões de classificação em volume quanto o jurídico:
- ▸Triagem e distribuição de processos: classificar cada nova peça por área (trabalhista, cível, tributário, penal), por tribunal e por complexidade, roteando para a equipe certa com confiança anexada, e escalando para revisão humana exatamente os casos de confiança baixa, que são justamente os que merecem olhar experiente.
- ▸Classificação documental: decidir se um anexo é petição inicial, contestação, decisão interlocutória ou sentença antes de indexá-lo, o passo que hoje trava pipelines inteiros de gestão de acervo.
- ▸Roteamento de consulta em bases jurídicas: a pergunta “qual é o prazo para recorrer desta decisão judicial?” é roteada para a base vetorial de Direito antes de qualquer busca, e só então o LLM redige a resposta fundamentada.
- ▸Verificação e guardrails: checar se uma minuta gerada por LLM cita apenas dispositivos presentes no acervo, se o valor da causa está dentro da alçada, se o documento exige assinatura de sócio: decisões sim/não em cada peça, a preço de centavos.
Num setor em que erro de classificação tem custo regulatório e prazo processual é fatal, o desenho em três faixas de confiança (automatiza o óbvio, consulta o intermediário, escala o duvidoso) é praticamente uma descrição de como um bom escritório já organiza o trabalho humano.
4.4 Saúde
Na saúde, a mesma lógica aparece com uma camada extra de responsabilidade:
- ▸Triagem e classificação de risco: protocolos como a escala de Manchester são, em essência, árvores de decisão: um modelo de decisão tipada pode classificar a prioridade de cada paciente que chega e devolver a confiança junto, encaminhando os casos incertos para avaliação de um profissional, nunca para automação cega.
- ▸Roteamento clínico e de exames: direcionar solicitações para a especialidade correta, identificar exames fora de protocolo, decidir se um caso se enquadra numa diretriz clínica específica antes de recuperar as evidências.
- ▸Guardrails em pipelines clínicos com IA: verificar, a cada saída de um modelo generativo, se a recomendação está dentro do escopo permitido, se menciona medicamento fora do formulário, se exige revisão médica obrigatória: checagens sim/não em 100% das saídas, algo inviável com o custo de um LLM por verificação.
Aqui a calibração deixa de ser virtude técnica e vira requisito de segurança: um sistema que diz “95% de confiança” precisa errar ~5% das vezes, e isso só se prova medindo nos dados reais da instituição, antes de automatizar qualquer coisa que toque um paciente. A promessa do RLCD é exatamente essa, mas promessa de calibração se valida na sua aplicação, não no paper do fabricante.
4.5 O que já apareceu na prática
Nos primeiros dias após o lançamento, desenvolvedores conectaram o Jev a automação de navegador, análise de anúncios, revisão de segurança de comandos e triagem de e-mails corporativos, e até pipelines clínicos, segundo relatos da comunidade. O padrão se repete: o modelo de decisão não substitui o LLM; o Jev decide, o software executa, o LLM conversa e gera.
5. O que ainda não sabemos e o que fica
Honestidade exige listar as lacunas: a TypeSafe não divulgou o tamanho do modelo, a arquitetura em detalhe, os datasets de treino, nem a matemática do RLCD. Não sabemos como a calibração se comporta fora da distribuição de treino, como a precisão degrada quando o número de opções cresce, quais são os failure modes e, para nós, um detalhe nada trivial: como o modelo se sai em português. Dois anos de stealth significam dois anos de avaliações internas que ninguém fora da empresa viu.
Mas a observação de partida independe dessas respostas, e ela é quase certamente correta: muita chamada de IA dentro de software não precisa produzir linguagem, e sim tomar uma decisão. Kahneman mostrou que a inteligência humana é, em essência, a disciplina de não gastar deliberação onde um reflexo bem calibrado resolve. A arquitetura de software com IA está aprendendo a mesma lição, vinte e cinco anos depois.
Menos conversa. Mais decisão.
Fontes
- Kahneman, D. Rápido e Devagar: Duas Formas de Pensar (Thinking, Fast and Slow, 2011).
- TypeSafe AI. Introducing System One Models and Jev (post de lançamento, set/2026) e documentação oficial (docs.typesafe.ai).
- Macedo, S. Jev: o modelo da TypeSafe que não conversa, decide, Blog do Sandeco, 18/09/2026.
- The Register. TypeSafe AI debuts model for machines that plays Doom (set/2026).
- Coberturas de lançamento: SiliconANGLE, Business Wire, TechCrunch, InfoWorld (set/2026): saída de stealth, rodada de US$ 40M liderada pela DCVC, fundadores.
- Testes públicos de terceiros citados: Vercel (classificador de segurança) e Bryo AI (comparativo com Gemini), set/2026.
Pronto para eliminar a cola humana?
Converse com nossos especialistas e descubra como a Fábrica de Agentes se encaixa na sua operação.
Falar com um especialista